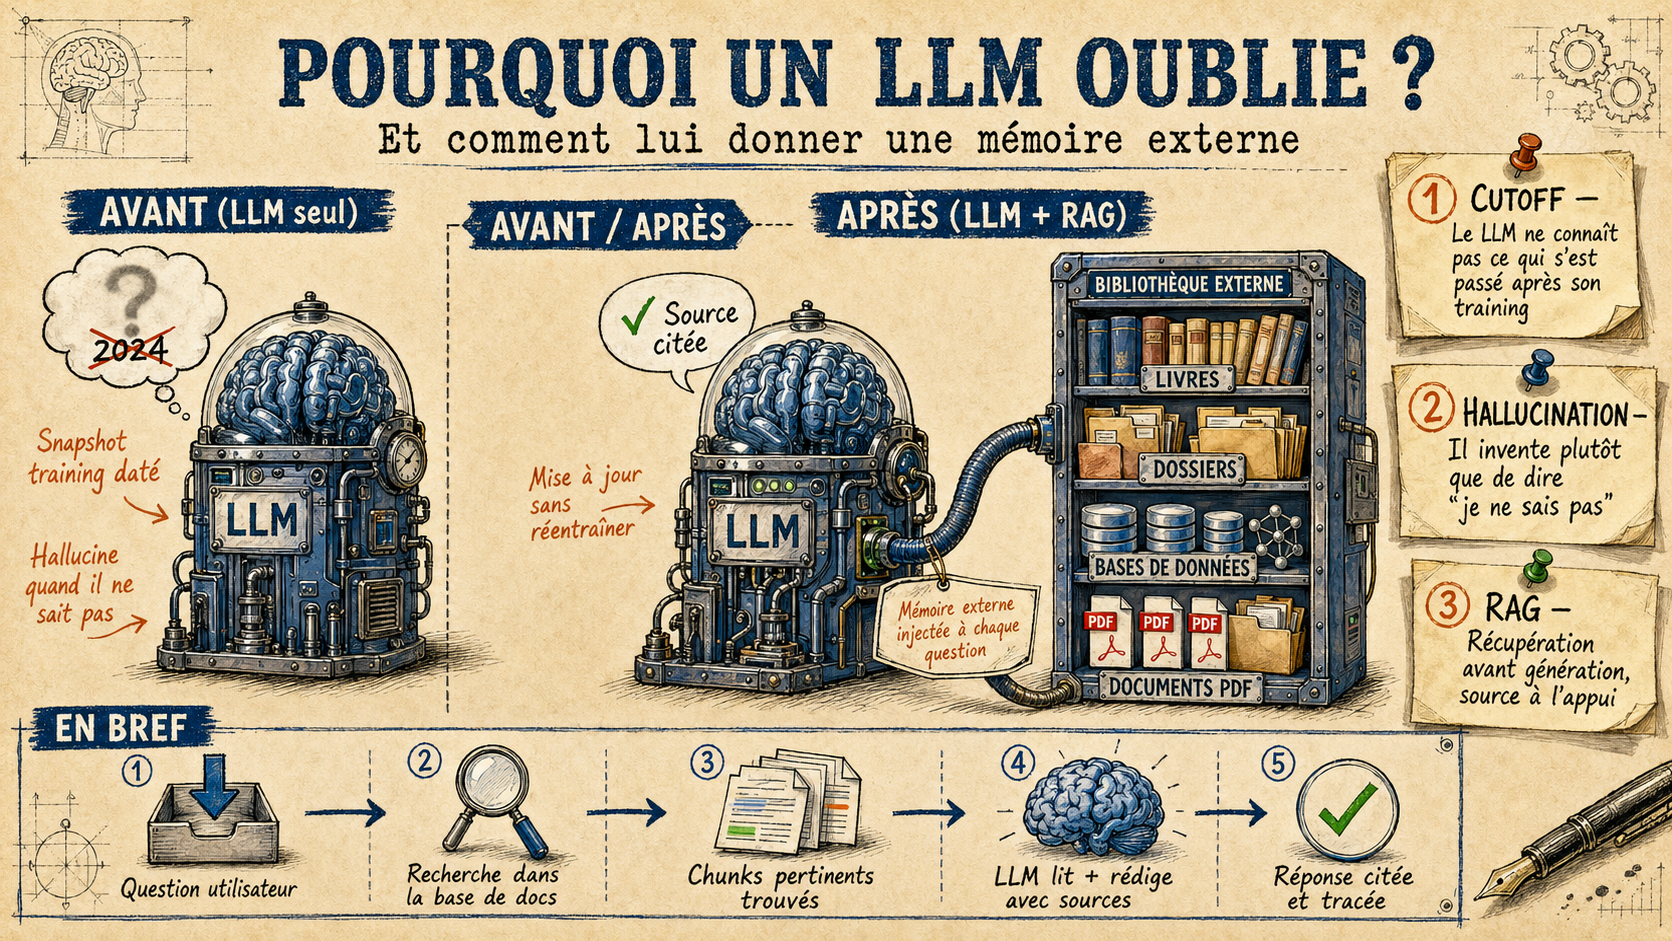
Accroche
Tu as ouvert ton copilote LLM hier. Tu lui as demandé de te citer la décision interne D-RND-289 prise il y a deux mois sur les workflows multi-terminal. Le copilote te répond avec assurance, avec le bon ton, avec un numéro plausible — sauf que la décision n’existe pas sous cette forme. Tu ouvres le fichier source : ce qui est écrit n’a aucun rapport.
Ce n’est pas un bug. C’est le comportement par défaut. Un LLM (un Large Language Model, un grand modèle de langage), c’est un système qui produit du texte vraisemblable, pas du texte vrai. Il n’a jamais lu tes documents internes. Il n’a aucune idée de ce qui s’est écrit chez toi cette semaine. Et quand on lui demande quelque chose qu’il ne sait pas, il ne dit pas « je ne sais pas » — il invente, parce qu’inventer du texte plausible, c’est exactement la tâche pour laquelle il a été entraîné.
Cette leçon explique pourquoi ce problème existe et quelle architecture on a inventée pour le contourner. Pas une ligne de code. Pas une formule. Juste l’intuition.
Pourquoi le LLM oublie
Imagine un employé super doué que tu as recruté il y a deux ans, mais qui a quitté la boîte il y a six mois. Sur la stratégie générale et les standards d’il y a un an, il répond parfaitement. Sur ce qui s’est décidé ce mois-ci, il ne peut pas savoir : il était parti.
Un LLM est dans cette situation. Il a été entraîné sur un grand volume de texte public jusqu’à une date de coupure — c’est le cutoff training : la date à partir de laquelle le modèle n’a plus rien vu. Chaque fournisseur publie cette date dans la fiche de ses modèles : c’est la première chose à regarder avant de lui demander ce qui s’est passé récemment. Tout ce qui a été publié après — y compris ta documentation interne, qui n’a jamais été publique — est invisible.
Analogie infra : le cutoff, c’est un
mysqldumpfigé à une date précise. Le modèle restaure ce dump et ignore tout ce qui s’est inséré depuis.
Quand tu poses une question qui touche à ce qui n’était pas dans le dump, le LLM ne renvoie pas d’erreur. Il hallucine — il invente une réponse plausible, dans le bon style, sans fondement réel.
Analogie infra : une hallucination, c’est un endpoint API mock qui renvoie
200 OKavec du JSON inventé. Format valide, code de retour bon, l’aval ne détecte rien — mais la donnée est fausse.
Ton copilote te sort une réponse fausse sur un document interne écrit la semaine dernière. Tu t’apprêtes à ouvrir un ticket « le modèle est buggé ». Pourquoi ce ticket va-t-il être refermé sans correctif ?
Réponse
Parce qu’il n’y a rien à corriger dans le modèle : il n’a jamais vu ce document. Il a arrêté d’apprendre à sa date de coupure, et ton wiki interne n’a de toute façon jamais été public. Le modèle ne « se trompe » pas au sens où un programme se trompe — il fait exactement ce pour quoi il est entraîné, produire du texte vraisemblable. Le défaut n’est pas dans le modèle, il est dans l’architecture : personne ne lui a donné le document.
Pourquoi la mémoire interne du LLM ne suffit pas
Premier réflexe : « je vais lui copier-coller toute ma doc dans le prompt. » Ça marcherait si la limite n’existait pas. Elle existe.
Chaque modèle a une fenêtre de contexte (context window) : la quantité maximum de texte qu’il peut lire en une seule requête, exprimée en tokens — l’unité que le modèle digère : un morceau de mot, si bien qu’un mot français en consomme souvent plusieurs, et le rapport change d’un tokeniseur à l’autre (tokens et tokenisation).
Analogie infra : la fenêtre de contexte, c’est un buffer mémoire d’entrée à taille fixe. Sa taille se lit dans la fiche du modèle et grandit d’une génération à l’autre : un million de tokens sur les Claude de génération 5, deux cent mille sur Haiku 4.5 (la famille Claude). Tout ce qui dépasse est tronqué — comme un
read()qui s’arrête à la taille du buffer alloué.
Et même si ta doc tient dans le buffer, deux problèmes restent. Le coût : facturé au token entrant, charger 1 million de tokens à chaque question coûte plusieurs euros par requête. La dilution : le modèle extrait mal une information précise noyée au milieu d’un très long contexte (phénomène mesuré et nommé « lost in the middle »).
Conclusion : on ne peut pas tout coller. Il faut être sélectif.
Gemini annonce une fenêtre d’un million de tokens. Ta documentation interne complète en fait huit cent mille. Donc le problème est réglé : on colle tout, à chaque question. Qu’est-ce qui cloche dans ce raisonnement ?
Réponse
Deux choses, et aucune n’est la taille du buffer.
Le prix. Tu paies au token entrant. Recharger 800 000 tokens à chaque question, c’est plusieurs euros la question — multiplie par le nombre de collègues et par le nombre de jours.
La dilution. Un modèle retrouve mal une phrase précise noyée au milieu d’un très long contexte ; le phénomène est mesuré et porte un nom, lost in the middle. Autrement dit : plus tu lui en donnes, moins il vise juste. Donner beaucoup n’est pas donner bien.
L’idée du RAG : attacher une mémoire externe
L’idée du RAG (Retrieval-Augmented Generation, génération augmentée par la recherche) tient en une phrase : on ne donne au LLM que les morceaux de doc utiles à la question, sélectionnés à la volée par un système séparé.
C’est, littéralement, attacher une bibliothèque externe au modèle. Quand tu poses une question, un composant intermédiaire va chercher dans tes documents les passages pertinents et les colle dans le prompt avant d’appeler le LLM.
Le RAG, c’est « Wikipedia attaché à ChatGPT en temps réel ». Le LLM ne sait toujours rien de tes docs — mais il a un assistant qui lit pour lui et lui passe les bons passages au bon moment.
Côté infra : un cache et un index externes, un Redis pour LLM. La mémoire vit dehors, dans un store qu’on contrôle, qu’on met à jour, qu’on interroge.
Le pipeline tient en trois mouvements :
Le schéma en texte
- Question utilisateur → Recherche dans les docs
- Recherche dans les docs → Passages pertinents
- Passages pertinents → Prompt enrichi
- Prompt enrichi → LLM répond + cite
Tu poses une question. Un module de recherche fouille dans une base externe (tes wikis, tes PDF, ton corpus). Il en sort 5 à 20 passages candidats. Ces passages sont collés dans le prompt avec une consigne au LLM du genre « réponds en t’appuyant uniquement sur ces sources ». Le LLM rédige et cite.
Trois conséquences directes
Une fois cette architecture en place, trois choses changent.
1. Tu peux citer la source. Le LLM ne « sait » plus la réponse, il la lit dans les passages fournis. Tu peux lui demander d’indiquer pour chaque assertion quelle source l’a alimentée. L’audit devient possible — c’est la différence entre une réponse vérifiable et une parole d’oracle.
2. Tu mets à jour la mémoire sans réentraîner le modèle. Ajouter un document à ta base, c’est une indexation : quelques secondes, quelques centimes. Réentraîner un LLM, c’est des semaines de calcul et plusieurs millions d’euros. La séparation mémoire / cognition rend l’évolution du corpus indolore.
3. Tu changes de LLM sans rebuilder le corpus. Demain une nouvelle génération de modèle sort, ou tu bascules sur un modèle ouvert hébergé chez toi. Ta base de connaissance reste la même, tu changes le composant de génération. Architecture découplée, comme une appli web où tu changes de runtime sans toucher à la base de données.
Le coût caché
Le RAG ne supprime pas le risque d’erreur. Il le déplace.
Avant, le risque vivait à un seul endroit : le LLM pouvait halluciner sur n’importe quel sujet. Maintenant, le LLM s’appuie sur les passages fournis — il hallucine moins, mais le système peut mal chercher : rapporter des passages hors-sujet ou rater le bon passage pourtant présent dans la base.
Le schéma en texte
- Avant RAG : Question, LLM seul, Réponse peut-être inventée
- Avec RAG : Question, Recherche, Passages peut-être mauvais, LLM contraint, Réponse sourcée si retrieval correct
- Question → LLM seul
- LLM seul → Réponse peut-être inventée
- Question → Recherche
- Recherche → Passages peut-être mauvais
- Passages peut-être mauvais → LLM contraint
- LLM contraint → Réponse sourcée si retrieval correct
- Hors liens : AVANT, APRES
On a ajouté deux composants probabilistes — le découpage des documents (chunking) et leur conversion en représentations cherchables (embedding) — qui peuvent mal s’aligner avec la sémantique du corpus. RAG-01 les démonte un par un.
Analogie infra : avant, un seul service à monitorer (le LLM). Avec le RAG, trois (recherche, augmentation, génération). Le débogage se déplace : « la réponse est fausse » devient « lequel des trois composants a fauté ? ». Compromis classique d’architecture distribuée — plus de pièces, plus de leviers, plus de surface de panne.
On dit souvent que « le RAG règle le problème des hallucinations ». En quoi cette phrase est-elle fausse — et qu’est-ce qu’elle devrait dire à la place ?
Réponse
Le RAG ne supprime pas le risque, il le déplace. Avant, un seul composant pouvait mentir : le modèle. Maintenant le modèle est contraint par des passages fournis, donc il invente moins — mais deux nouveaux composants peuvent échouer avant lui : le découpage et la recherche. Si la recherche ramène le mauvais passage, le modèle répondra faux en citant sa source, ce qui est plus trompeur qu’une hallucination franche.
Formulation honnête : « le RAG remplace un risque diffus et invérifiable par un risque localisé et auditable ». C’est un très bon échange — mais c’est un échange, pas une suppression.
À toi de jouer
Cinq minutes, aucun code, sur le copilote que tu utilises déjà.
- Pose-lui une question dont tu connais la réponse et qui porte sur un document interne récent — une décision, une procédure, un nom de projet.
- Note s’il dit « je ne sais pas », ou s’il répond quand même. Note surtout le ton : la confiance affichée est-elle corrélée à la justesse ?
- Repose la même question en collant toi-même le passage source dans la conversation.
- Compare les deux réponses.
Ce que tu viens de faire à la main, à une question, c’est exactement ce qu’un système RAG fait automatiquement, à chaque question, sur des milliers de documents. Le reste du cours explique comment on automatise l’étape 3 — et pourquoi c’est plus difficile qu’il n’y paraît.
Ce que tu vas apprendre dans la suite
Cette leçon était l’intuition. Les suivantes démontent le mécanisme :
Le schéma en texte
- RAG-00 Pourquoi → RAG-01 Anatomie 5 composants
- RAG-01 Anatomie 5 composants → RAG-02 Chunking
- RAG-01 Anatomie 5 composants → RAG-03 Embeddings
- RAG-01 Anatomie 5 composants → RAG-04 Vector stores
- RAG-01 — Anatomie d’un pipeline RAG : les 5 composants avec un peu de code Python pour matérialiser.
- RAG-02 — Stratégies de chunking : comment on découpe les documents, et pourquoi le choix de la frontière compte autant.
- RAG-03 — Embeddings : la « magie » qui transforme un texte en vecteur cherchable, et le choix du modèle adapté à ton corpus.
- RAG-04 — Vector stores : où on stocke ces vecteurs pour les retrouver vite, et quel outil pour quelle échelle.
À la fin de RAG-04, tu sauras justifier en 30 secondes pourquoi un copilote interne te répond mal et quel composant changer en premier.
Glossaire
Format : TERME — définition courte + analogie infra quand pertinente.
- LLM (Large Language Model) — Grand modèle de langage. Système qui produit du texte vraisemblable à partir d’un texte d’entrée. Analogie : un moteur de génération de texte statistique, sans conscience ni intention.
- Prompt — Le texte d’entrée envoyé au LLM. Analogie : le
stdinque tu lui passes. - Token — Unité élémentaire que digère le modèle (un morceau de mot : un mot français en consomme souvent plusieurs, et le rapport dépend du tokeniseur). Analogie : un slug d’URL découpé par segments par un parseur.
- Cutoff training — Date à laquelle le modèle a arrêté d’apprendre. Au-delà, il ne sait rien. Analogie : un
mysqldumpfigé à une date précise. - Contexte (context window) — Quantité maximum de tokens que le LLM peut lire en une requête. Analogie : un buffer mémoire d’entrée à taille fixe.
- Hallucination — Réponse inventée par le LLM, plausible mais sans fondement réel. Analogie : un endpoint API mock qui renvoie
200 OKavec du JSON inventé. - RAG (Retrieval-Augmented Generation) — Architecture qui attache au LLM une mémoire externe interrogée à chaque question. Analogie : Wikipedia branché à ChatGPT en temps réel.
- Corpus — L’ensemble des documents dans lesquels le système RAG va chercher. Analogie : ta base de données documentaire.
- Embedding — Représentation d’un texte sous forme de vecteur de nombres. Deux textes proches en sens donnent deux vecteurs proches en géométrie. Analogie : un hash, mais sémantique (≠ MD5/SHA qui change radicalement à 1 char près).
- Vector store — Base de données spécialisée pour stocker et chercher des vecteurs. Analogie : Redis, mais indexé par similarité au lieu de clé.
- Retrieval — L’étape de recherche qui rapporte les passages pertinents à partir d’une question. Analogie : un cache lookup, mais par similarité au lieu d’égalité de clé.
- Mémoire externe — Le corpus indexé, vivant en dehors du modèle, qu’on peut mettre à jour sans réentraîner. Analogie : un volume de stockage attaché à un conteneur, vs un état embarqué dans l’image.